Asosiy ma’lumotlar
- Irene Solaiman (Hugging Face): AI benchmarklari — «rivojlanayotgan ilm», testlarni bir-biri bilan solishtirishni hali o‘rganmaganmiz.
- Baholash natijalarini takrorlash modelga kirish imkoniyatiga bog‘liq — ochiq vaznlar muhim rol o‘ynaydi.
- Baholash modeldan butun tizimga o‘tmoqda: harness va agent kuchsiz modelga frontier-model ustidan afzallik berishi mumkin.
AI benchmarklari hali izchil ilmga aylanmagan
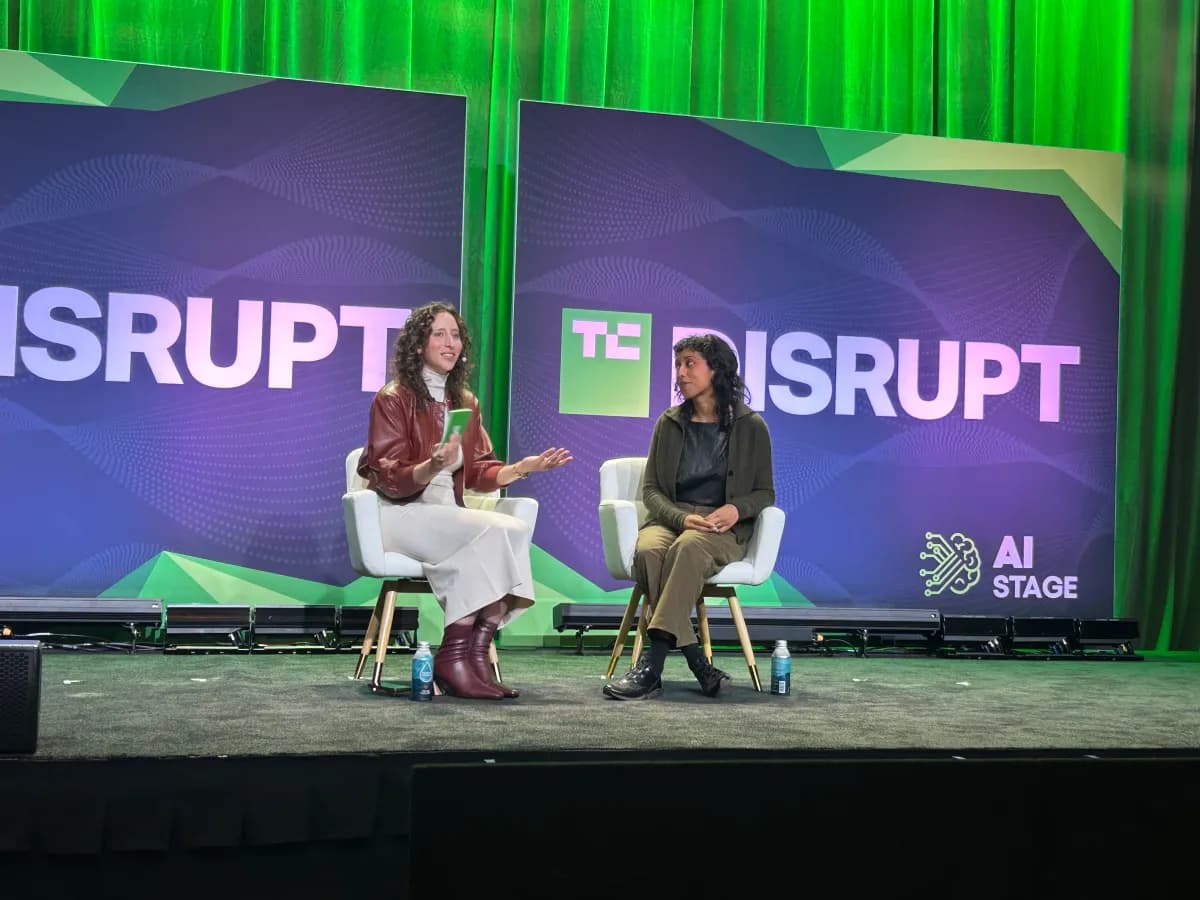
AI laboratoriyalari o‘z obro‘sini ko‘p jihatdan benchmarklarga — qaysi model yaxshiroq ekanini betaraf va aniq ko‘rsatishi kerak bo‘lgan baholashlarga tayanib quradi. Biroq bu baholash usullari murakkab va hali ham shakllanmoqda, deya TechCrunch Disrupt munozarasi davomida Hugging Face siyosat bo‘yicha direktori Irene Solaiman ma’lum qildi. Uning so‘zlariga ko‘ra, sanoat kelajakda testlarga tayanishi uchun ular izchilroq ilmga aylanishi kerak.
Ishonch va takrorlanuvchanlik
«Ishonch — juda ko‘p ma’no yuklangan atama», dedi Solaiman. Asosiy savol — baholash natijalarini takrorlash mumkinmi, buning uchun modelning o‘ziga yetarli kirish imkoniyati kerak; bu yerda, uning so‘zlariga ko‘ra, ochiq vaznlar katta rol o‘ynaydi. Takrorlanuvchanlik benchmarkingning eng bahsli jihatlaridan biri bo‘lib, sanoatda jiddiy tortishuvlar predmeti bo‘lib kelmoqda. Bundan tashqari, uning bahosiga ko‘ra, testlar — «rivojlanayotgan ilm», va ularni bir-biri bilan mazmunli solishtirishni hali bilmaymiz.
Ichki baholovchilar va Anthropic qaroriga tanqid
Solaiman qo‘shimcha qilishicha, testlar «tez samaradorligini yo‘qotmoqda», baholash ekotizimi yetarli rivojlanmagan: «Ichki baholovchilar ekotizimiga ochlik bor, lekin kim samarali baholovchi va qanday vazifalar uchun ekanini belgilovchi malakalar ancha katta standartlashtirishni talab qiladi». Ichki baholovchilar — go‘yoki betaraf uchinchi tomon kuzatuvchilari AI tashkilotlari ichida — g‘oyasi so‘nggi oylarda bir qator xavfsizlik hodisalari fonida mashhurlik kasb etdi, ulardan biri Hugging Face’ning o‘ziga tegishli edi. Laboratoriyalar faol davlat tartibga solish o‘rniga uchinchi tomon yechimini ilgari surmoqda, ammo baholovchilarning betarafligi va samaradorligi haqidagi shubhalar saqlanmoqda: Anthropicning birinchi baholovchi sifatida Accentureni yollash qarori sezilarli tanqidga uchradi — sharhlovchilarning bir qismi konsalting firmasi bunday vazifa uchun malakali ekaniga shubha qildi.
Baholash modeldan butun tizimga surilmoqda
Baholashlar modelning o‘zini tekshirishdan uning atrofidagi butun tizimni, jumladan harness va agentni tekshirishga ko‘chmoqda. Harness — foydalanuvchi modelga murojaat qiladigan vosita — natijalarga kuchli ta’sir qiladi: kuchsiz model yaxshi harness bilan frontier-modelni osongina ortda qoldirishi mumkin, dedi Solaiman. «Agent baholashlari juda murakkab va juda qimmat. Bizda modellar uchun baholashlar ko‘proq… harnesslar uchun baholashlar kamroq, biz butun agent uchun yaxshiroq baholashlarni ishlab chiqmoqdamiz — chunki ko‘pchilik qiymatni aynan shu yerdan oladi», — dedi u. Uning xulosasiga ko‘ra, baholash maydoni hozir «umumiy axlatxonaga» o‘xshaydi va agar benchmarking foydali vosita bo‘lib qolishi kerak bo‘lsa, yanada yagona tarmoq yondashuvi kerak bo‘lishi mumkin.