Главное в материале
- Ирен Солайман (Hugging Face): бенчмарки ИИ — «эволюционирующая наука», сравнивать тесты между собой пока не научились.
- Воспроизводимость оценок зависит от доступа к модели — важную роль играют открытые веса.
- Оценки смещаются с модели на всю систему: обвязка (harness) и агент могут дать слабой модели преимущество над frontier-моделью.
Бенчмарки ИИ пока не стали последовательной наукой
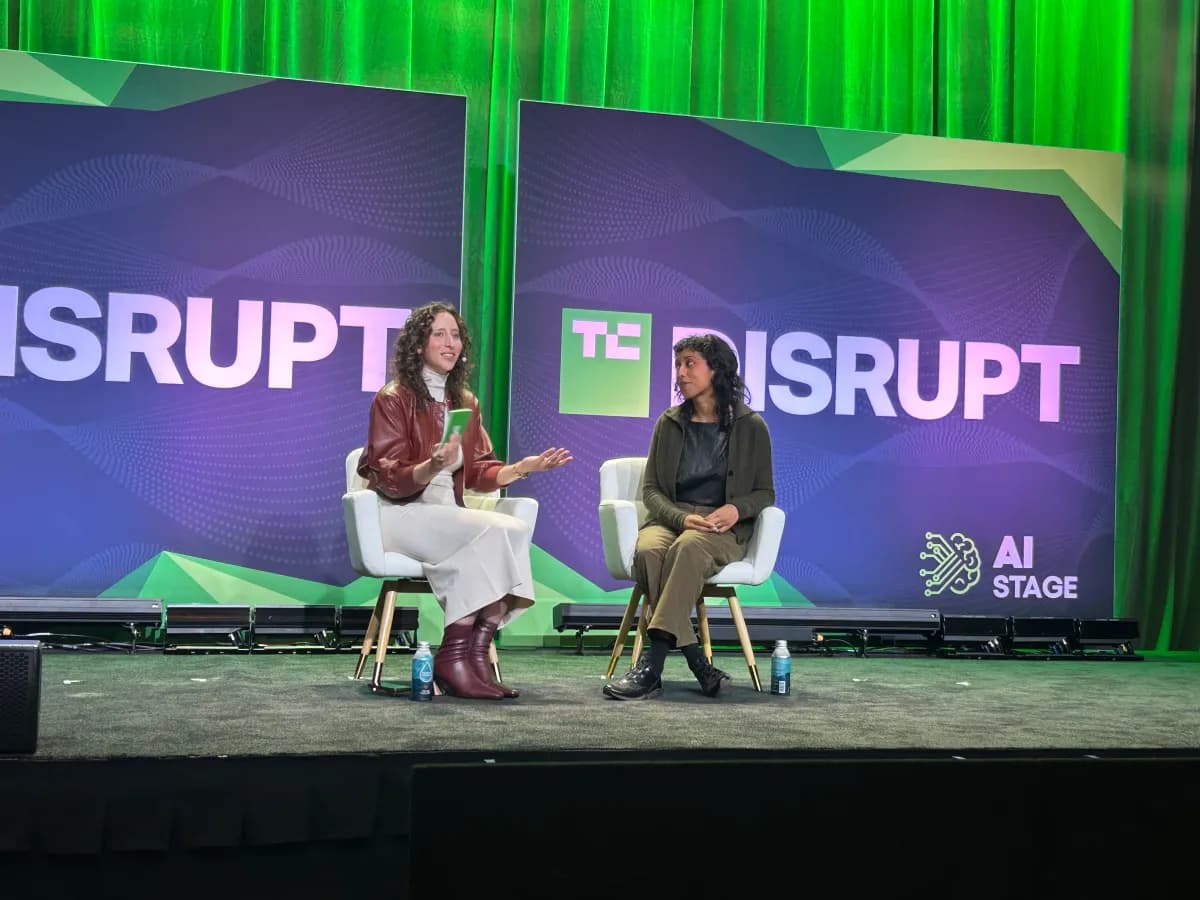
ИИ-лаборатории во многом строят репутацию на бенчмарках — оценках, которые должны нейтрально и точно показывать, какая модель лучше. Однако методы этих оценок сложны и всё ещё формируются, заявила Ирен Солайман, директор по политике Hugging Face, в ходе дискуссии на TechCrunch Disrupt. По её словам, чтобы индустрия могла опираться на тесты в будущем, им нужно превратиться в более последовательную науку.
Доверие и воспроизводимость
«Доверие — очень нагруженный термин», отметила Солайман. Ключевой вопрос — можно ли воспроизвести результаты оценки, а для этого нужен достаточный доступ к самой модели; здесь, по её словам, большую роль играют открытые веса. Воспроизводимость давно остаётся одним из самых спорных аспектов бенчмаркинга и предметом значимых споров в индустрии. Кроме того, по её оценке, тесты — «эволюционирующая наука», и пока непонятно, как осмысленно сравнивать их друг с другом.
Встроенные оценщики и критика решения Anthropic
Солайман добавила, что тесты «быстро теряют эффективность», а экосистема оценок недостаточно развита: «Есть голод по экосистеме встроенных оценщиков, но квалификации, определяющие, кто эффективный оценщик и для каких задач, требуют гораздо большей стандартизации». Идея встроенных оценщиков — якобы нейтральных сторонних наблюдателей внутри ИИ-организаций — набрала популярность за последние месяцы на фоне череды инцидентов безопасности, один из которых затронул саму Hugging Face. Лаборатории продвигают стороннее решение вместо активного госрегулирования, но сомнения в нейтральности и эффективности оценщиков сохраняются: решение Anthropic нанять Accenture первым оценщиком вызвало заметную критику — часть обозревателей сомневалась, что консалтинговая фирма квалифицирована для такой задачи.
Оценка смещается с модели на всю систему
Оценки перемещаются от проверки самой модели к проверке всей системы вокруг неё, включая обвязку (harness) и агента. Обвязка — инструмент, через который пользователь обращается к модели, — сильно влияет на результаты: слабая модель с хорошей обвязкой может легко обойти frontier-модель, отметила Солайман. «Агентные оценки очень сложны и очень дороги. У нас больше оценок для моделей… оценок для обвязок меньше, а мы разрабатываем лучшие оценки для целостного агента — потому что именно оттуда многие получают ценность», — сказала она. По её выводу, пространство оценок сейчас похоже на «всеобщую свалку», и если бенчмаркинг должен оставаться полезным инструментом, может понадобиться более единый отраслевой подход.