Главное в материале
- Сбой Microsoft 365 длился более 22 часов, проблемы зафиксированы более чем в 70 странах
- Причиной стали рутинные автоматические проверки, перегрузившие оставшиеся серверы
- Microsoft исключила кибератаку и извинилась; восстановление шло постепенно ради стабильности
Что произошло
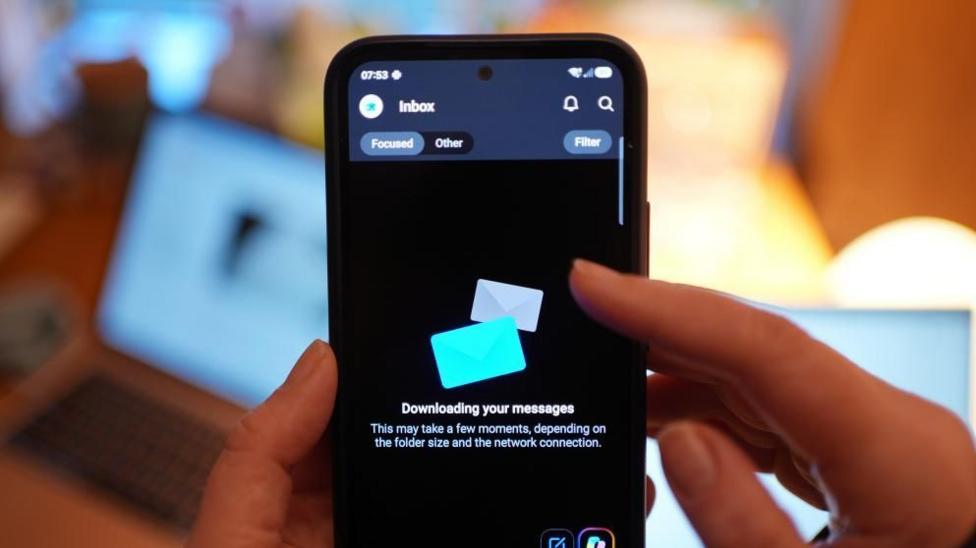
Критический сбой в сервисах Microsoft 365, включая Outlook и Teams, продолжался более 22 часов. По данным компании, причиной стали рутинные автоматические проверки, которые вывели часть серверов из строя, перегрузив оставшиеся трафиком. Восстановление заняло почти полные сутки: инженеры возвращали сервисы постепенно, поскольку, по словам представителя Microsoft, «учитывая масштаб спроса» такой подход «помог обеспечить стабильное восстановление». Компания извинилась и заявила, что речь идёт о технической неисправности, а не о кибератаке. Позднее Microsoft сообщила, что очереди писем «приближаются к нормальным уровням», и что она изучает причины сбоя, чтобы предотвратить подобное в будущем.
Масштаб последствий
Microsoft 365 используют около 430 млн человек в мире, а сообщения о проблемах поступали более чем из 70 стран. Сбой вывел из строя почтовые системы Палаты представителей США и австралийских разведывательных агентств, нарушил работу судов в Сингапуре и служб поддержки авиакомпаний в Индии. Флора Гамильтон, исполнительный директор Small Business Charter, назвала произошедшее «явным напоминанием» о том, насколько компании зависят от цифровых систем: для многих малых и средних предприятий доступ к электронной почте фундаментален — от общения с клиентами и поставщиками до генерации дохода.
Вопросы к устойчивости инфраструктуры
Эксперты указали на уязвимость, которую обнажил сбой. Стратег в сфере ИИ Уолтер Паскуарелли заявил, что для правительств, бизнеса и критической инфраструктуры инцидент «наглядно показал их уязвимости и зависимость», и предупредил, что по мере подключения ИИ-ассистентов к почте, календарям и файлам подобные сбои могут распространяться ещё шире. Бывший ведущий инженер крупных технологических компаний Гергей Оросз отметил, что сами по себе такие сбои не редкость — необычной была именно длительность восстановления. Он связал произошедшее с зависимостью от нескольких крупных американских корпораций и предложил возможное решение: разделение сервисов по регионам для снижения масштаба последствий, как это уже практикуется в облачном сервисе Amazon AWS.
 Источник изображения, Getty Images