Главное в материале
- OpenAI заявила о решении задачи Навье–Стокса за 88 часов; математик из NYU усомнился, не использовала ли компания его черновики
- До 17% текстов рецензий на конференциях по computer science существенно переписаны языковой моделью
- Около 147 000 фантомных исследований были процитированы в научных работах за прошлый год
Спор вокруг уравнений Навье–Стокса
Конфликт между математиками стал для BBC InDepth поводом разобрать более широкую проблему: как применение ИИ влияет на доверие к научному процессу. В прошлом месяце OpenAI объявила, что её ИИ-агенты за 88 часов решили одну из великих нерешённых задач математики, связанную с уравнениями Навье–Стокса. Организация, учредившая приз за решение, заявила, что задача «по-видимому, решена», но проверка займёт время.
Обвинения и ответ OpenAI
За несколько часов до объявления математик из Нью-Йоркского университета Тристан Бакмастер выступил с опасениями. Вместе с Левентом Алпёге, который днём работал в компании-конкуренте Anthropic, он независимо шёл к той же цели и хранил черновики в инструменте OpenAI Codex. По словам Бакмастера, его соавтору сообщили, что новости об их прогрессе «дошли» до OpenAI — как именно, он не уточнил. Он спросил, не могли ли его исследования, хранившиеся в Codex, попасть в работу OpenAI, подчеркнув при этом, что «ни в чём никого не обвиняет». OpenAI ответила, что никто в компании — ни человек, ни ИИ — не видел работу других команд до публикации. Сначала компания заявила, что не может «исключить», хотя это маловероятно, что анонимизированные данные от использования её продуктов помогли улучшить модели, но через несколько дней сообщила, что запросы Бакмастера в Codex за два месяца до анонса «не могли повлиять на систему каким-либо образом». Как отмечает BBC, до конца неизвестно, что произошло на самом деле.
Фальшивые цитирования и «исследовательский мусор»
Помимо громких споров, есть более тихая угроза: засорение научных журналов так называемым ИИ-«мусором», когда тексты пишут не учёные, а машины, порождая фальшивые ссылки и фантомные статьи. В 2024 году команда профессора Дмитрия Кобака из Гентского университета проанализировала более миллиона биомедицинских работ на характерные для языковых моделей обороты: к декабрю прошлого года следы ИИ обнаружились почти в 90% из них. Детекторы несовершенны — некоторые из них пометили как «сгенерированный ИИ» текст Конституции США XVIII века, но сам Кобак сказал Nature, что шокирован масштабом. Команда Стэнфордского университета под руководством Вэйсин Лян и Джеймса Зоу установила, что до 17% текста рецензий на четырёх крупных конференциях по computer science были существенно переписаны языковой моделью. А исследователи из Корнеллского университета выяснили, что при составлении списков литературы ИИ изобретал несуществующие работы: за прошлый год процитировано около 147 000 фантомных исследований.
Спор о новизне результатов DeepMind
Даже реальная наука может подаваться с преувеличениями. После успеха AlphaFold, предсказавшего 200 миллионов укладок белков — работа, на которую в лабораториях ушли бы сотни миллионов лет, — DeepMind обратилась к предсказанию структур новых материалов и объявила более двух миллионов новых кристаллических структур как «почти 800 лет знаний». Химики из Калифорнийского университета Энтони Читэм и Рам Сешадри проверили случайную выборку и заключили в журнале Chemistry of Materials, что «пока не нашли ни одного поразительно нового соединения», назвав многие «тривиальными вариациями известных материалов». DeepMind отвергает обвинения, указывая, что проверяла каждое соединение на новизну: замена одного атома — так появлялись многие полезные сегодня материалы. Их вывод был не о том, что метод неверен, а о том, что результаты требуют большей проверки людьми.
Меры издателей и аргумент в пользу ИИ
Часть научных издательств уже реагирует. Команда Elsevier по целостности исследований разработала около 100 сигналов, по которым статья отправляется на дополнительную проверку человеком; журналы Nature запрещают сгенерированные ИИ изображения и предписывают рецензентам не загружать рукописи в ИИ-системы; arXiv банит авторов на год за выдуманные ссылки. Вице-президент Elsevier Сара Мейн говорит о «research-grade AI», где «исследователь за рулём». Руководитель научного направления DeepMind Пушмит Коли не считает выходом отказ от ИИ — это, по его словам, «как сказать, что нужно считать без калькуляторов», — но признаёт необходимость человеческого контроля: «Агенты сегодня несовершенны. Кто-то должен нести ответственность». Пример ответственного применения — лаборатория Андреа Паули из Венского биоцентра, которая почти десять лет искала ответ на вопрос, как сперматозоид проникает в яйцеклетку, и с помощью ИИ нашла белок на поверхности яйцеклеток рыбок данио, указывающий на механизм «замка и ключа». Основатель лондонской Basecamp Research Оливер Винс, собирающий ДНК для ИИ, который «говорит на языке биологии», после пережитой лейкемии ставит целью систему с бо́льшими шансами лечить рак: «У нас есть технически осуществимый путь к лечению рака». Это не обещание, подчёркивает BBC, а направление — и открытый вопрос в том, донесёт ли ИИ науку до этой цели или незаметно подточит её фундамент.
 Источник изображения, Getty
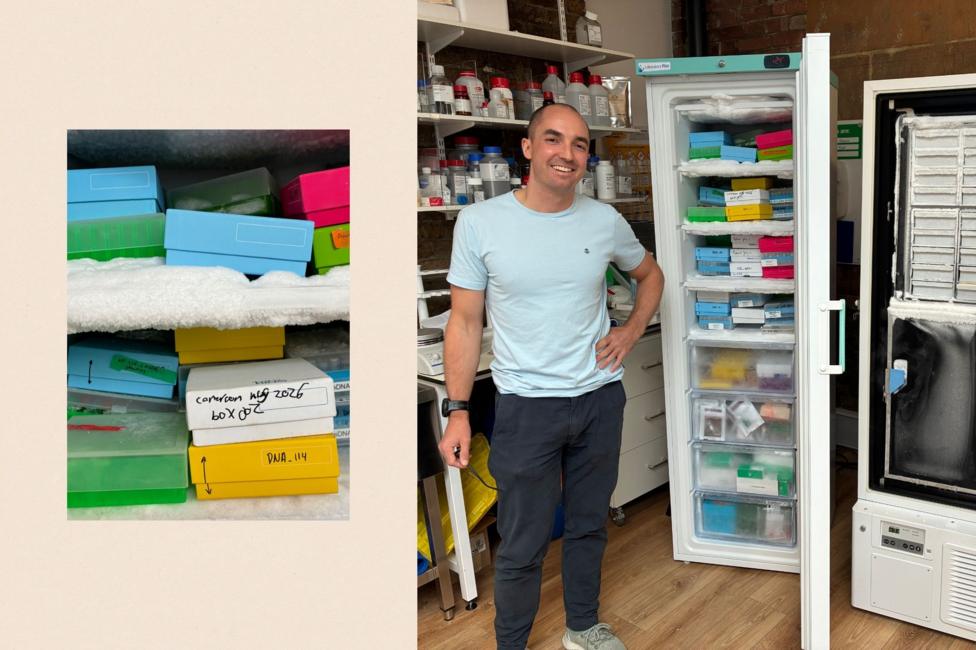
Основатель Basecamp доктор Оливер Винс говорит, что всего две коробки могут вместить в 10 раз больше информации, чем весь текст в интернете
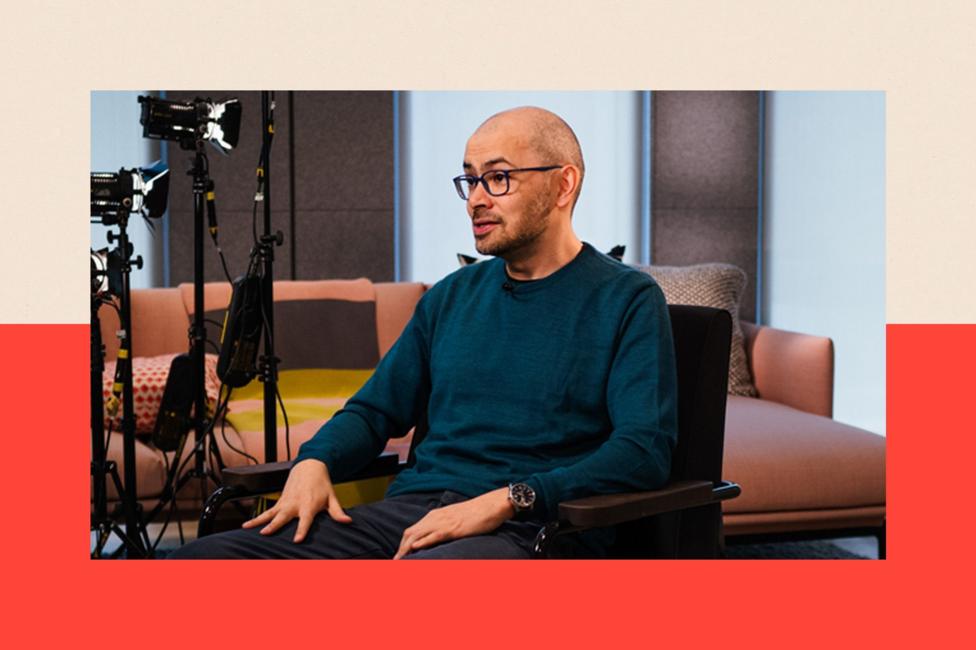 Источник изображения, Jose Sarmento Matos/Bloomberg via Getty Images
Генеральный директор DeepMind сэр Демис Хассабис отпраздновал использование своей компанией ИИ для решения одной из крупнейших проблем биологии
 Источник изображения, Universal History Archive/Universal Images Group via Getty Images
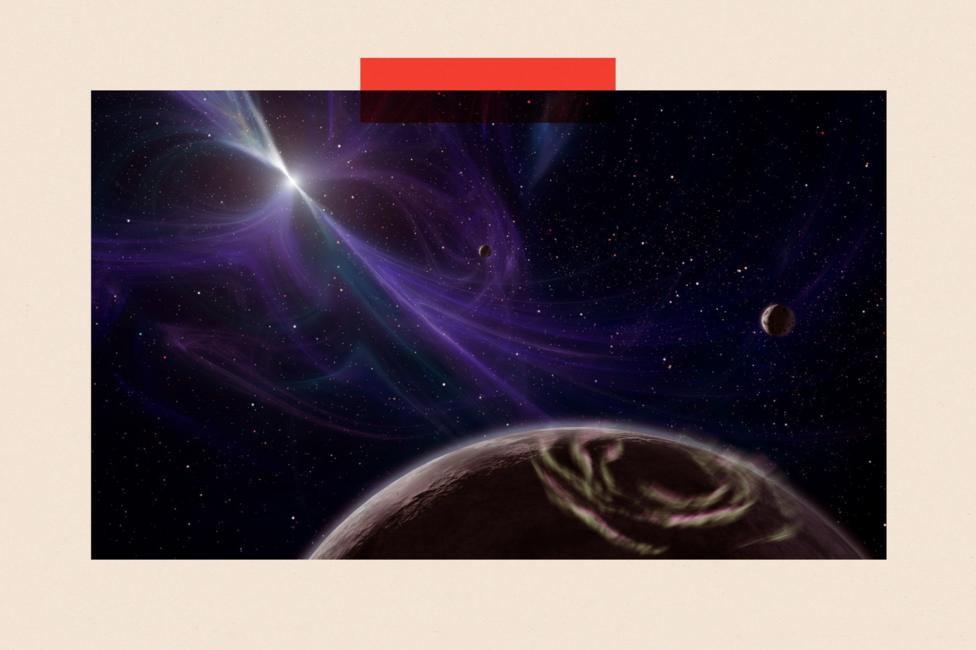
Пульсары — необычный тип нейтронных звёзд, изображённый выше художником — были открыты в 1960-х годах отчасти благодаря догадке учёных
 Источник изображения, Daily Herald Archive/SSPL/Getty Images
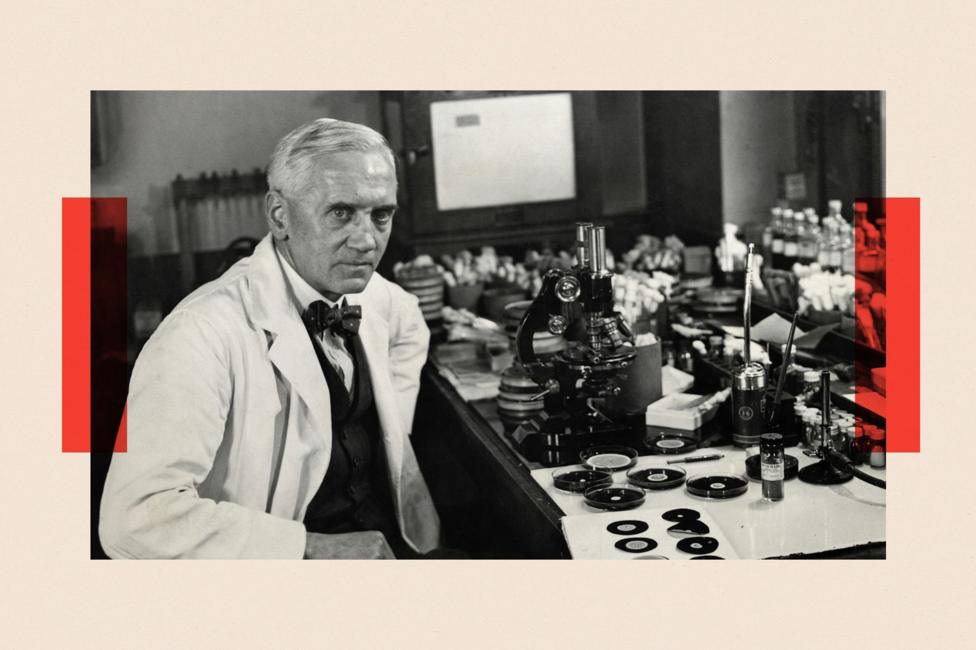
Шотландский учёный сэр Александр Флеминг открыл пенициллин в 1920-х годах